Le monde de l’intelligence artificielle vit un paradoxe architectural majeur. D’un côté, la production mondiale de données explose dans les bases transactionnelles (OLTP), les flux de réplication Change Data Capture (CDC), les journaux d’observabilité, les capteurs IoT, les tickets clients et les écritures financières. De l’autre, l’industrie tente encore d’appliquer l’IA à ces volumes avec des modèles génératifs conversationnels pensés pour la vitesse d’un lecteur humain : une requête à la fois, en 500 à 2 000 millisecondes, au prix fort du token sur GPU.
Ce décalage crée un mur infranchissable. Aujourd’hui, nous n’avons tout simplement pas de solution de traitement massif, rapide et peu coûteux des données par l’IA dans des situations réelles de production. Sans résoudre l’équation du coût et de la latence de décision à la ligne, l’avenir de l’analyse de données augmentée par l’IA reste bloqué au stade du prototype de laboratoire ou réservé à quelques requêtes interactives.
C’est précisément pour briser ce plafond de verre qu’est né MicroLLM (micro-jev) — une approche issue de l’ingénierie des bases de données et du traitement à grande échelle — et c’est dans cette exacte direction que vient de s’engager Google DeepMind avec le lancement de la Gemini Decisions API (gemini-decision-1).
1. L’Équation Impossible des Bases de Données : Le Coût Monstrueux d’une Décision par Donnée
En ingénierie des bases de données, toute architecture viable repose sur une arithmétique implacable : quel est le coût en CPU, en I/O et en temps pour évaluer un prédicat sur chaque ligne d’une table ou chaque événement d’un flux ?
Imaginons un cas banal en entreprise : qualifier, router ou scorer 100 millions de lignes (avis clients, lignes d’audit, logs applicatifs, alertes de sécurité, fiches produits ou événements CDC), avec environ 250 tokens par ligne, soit 25 milliards de tokens en entrée.
| Approche d’inférence | Latence unitaire (p50) |
Coût pour 100 M de lignes |
Débit (1 nœud / 1 thread) |
Viabilité dans un flux ou moteur de données |
|---|---|---|---|---|
| LLM Génératif Frontière (System-2) (70B+ / API Cloud, ~2,00 USD / 1M tokens) | 500–1 200 ms |
~50 000 USD par passe (+ génération JSON) | 1–2 déc./s (1,6 à 3,8 années séquentielles) |
Impossible en ligne, trop cher en batch quotidien |
API Cloud de Décision (Google Gemini Decision 1) (0,10 USD / 1M tokens d’entrée, 0 USD en sortie) |
50–100 ms calcul / 150–250 ms bout en bout |
~2 500 USD (facteur ×20 vs LLM génératif) | Limité par la latence réseau RTT & les quotas HTTP | Pertinent en palier d’escalade multimodal, mais hors de portée pour du filtrage local ligne à ligne |
| Classifieur neuronal supervisé 300M statique (tête fixe entraînée) | 15–60 ms sur CPU (< 1 ms sur GPU) |
Coût infra GPU ou CPU lourd (300 Mo – 1,2 Go RAM) |
16–66 déc./s sur un cœur CPU |
Rigide : tout changement de critère exige ré-étiquetage et ré-entraînement ; scores mal calibrés (ECE > 10 %) |
Micro-Décision Locale System-1 (MicroLLM v0.3.0 / micro-jev) |
0,076–0,369 ms sur CPU (0 % GPU) |
0,00 USD d’API (< 85 Mo RAM, profils ONNX ~58 Mo) |
2 145–8 601 déc./s sur 1 thread CPU (> 100 000 déc./s sur 16 cœurs) |
Natif au plus près de la donnée : critère zero-shot dynamique + abstention mathématique certifiée |
Le constat est sans appel : appeler un modèle génératif System-2 sur chaque donnée revient à exécuter un FULL TABLE SCAN en envoyant chaque ligne vers un serveur distant par HTTP synchrone pour exécuter un simple prédicat WHERE. Même à 2 500 USD par scan complet avec une API cloud spécialisée, la gravité des données (data gravity), la confidentialité et la latence réseau interdisent d’appliquer l’IA en continu au cœur des bases de données et des files d’événements.
Si l’IA veut devenir une primitive de base du traitement de la donnée, elle doit descendre sous la milliseconde et tendre vers un coût marginal proche de zéro.
2. La Convergence Majeure : La Démarche « Google Decisions » et la Vision MicroLLM
Le 11 novembre 2026, Min Choi (Product Manager, Google DeepMind) et Felix Yu (Principal Scientist, Google DeepMind) ont marqué un tournant historique en publiant l’annonce officielle de la Gemini Decisions API (gemini-decision-1).
Pourquoi cette annonce est-elle si importante pour l’industrie ? Parce que Google DeepMind y acte officiellement une rupture fondamentale que nous défendons depuis le premier jour avec MicroLLM :
- Fin du gaspillage autorégressif pour les décisions fermées : Au lieu de faire générer des tokens de texte un par un à un LLM pour obtenir un « oui/non », une catégorie ou une note sur une grille,
gemini-decision-1évalue les options candidates en une seule passe avant (single forward pass). - Des primitives décisionnelles typées et bornées : Oui/Non, choix multiple (
2à255options) et notation par rubrique ordonnée, jusqu’à1 000questions évaluées dans un même appel, avec un contexte partagé jusqu’à256Ktokens (texte, images, audio, vidéo, PDF). - Des probabilités calibrées et un score de confiance
[0, 1]: Chaque réponse est accompagnée d’une distribution de probabilité normalisée et d’un score de confiance permettant d’automatiser les cas certains et de dérouter les cas ambigus. - Le routage dynamique comme cas d’usage central : Google souligne lui-même l’usage de son modèle de décision comme plan de contrôle temps réel (notamment pour router les requêtes entre niveaux de modèles et budgets de réflexion).
Cette convergence validation scientifique et industrielle est totale. Là où Google Decisions industrialise la décision calibrée à l’échelle cloud et multimodale (150–250 ms), MicroLLM implémente en open source (Apache-2.0, spécification jevcompat 0.1 respectant 32/32 exigences MUST) le palier ultra-rapide et frugal de proximité (< 0,4 ms, 0 % GPU, < 85 Mo RAM) fondé sur trois papiers de recherche de référence :
- OpenJev-RLCD (
arXiv:2609.38850) : Entraînement en deux étapes Calibrate-then-Reinforce (RLCD²) pondéré parBeta(8, 2)pour aligner la confiance sur la précision réelle et éliminer la sur-confiance. - AnyJev (
arXiv:2610.00831) : Théorème 1 de rotation circulaireL₀dans l’espace des log-probabilités avec séquence de Van der Corput et arrêt anticipé, réduisant les passes de 78,3 % tout en garantissant un taux de bascule par ordre des options strictement égal à0,000000. - StartLux-Decision (
arXiv:2610.17309) : Cascade dynamique Read-or-Think (p = 0,25 p₀ + 0,75 p₁), tournoi hiérarchique 25-voies jusqu’à255options et Prédiction Conforme par Séparation (Split Conformal Prediction) pour certifier le signal d’abstention (x_abstain).
3. La Sagesse des Moteurs de Bases de Données : Le « Predicate Pushdown » de l’IA et l’Élimination de 60 % des Requêtes Inadaptées
Quand un moteur de base de données relationnelle ou analytique (PostgreSQL, MySQL, DuckDB, ClickHouse) doit traiter des milliards d’enregistrements, il applique une règle d’or vieille de cinquante ans : ne jamais transférer les données brutes vers le nœud de calcul le plus lourd ; pousser le filtrage au plus près du stockage et du client (Predicate Pushdown, Bloom Filters, Zone Maps).
En transposant cette philosophie aux pipelines d’IA actuels, un constat immédiat s’impose : dans la majorité des systèmes d’agents et des points d’entrée conversationnels, au moins 60 % des requêtes envoyées aux grands modèles génératifs sont inadaptées :
- Questions simples d’intention ou de routage résolubles par un choix fermé (
1parmiK) ; - Vérifications binaires de conformité, de règles métier ou de politique de sécurité (
noul) ; - Bruit, spams, doublons, requêtes hors périmètre ou tentatives d’injection de prompt ;
- Tâches de qualification répétitive de logs, tickets ou formulaires ne nécessitant aucune génération créative.
En positionnant un système de décision de Type 1 au plus près des clients, des passerelles API ou directement dans les nœuds de données, la transformation est immédiate :
- À court terme, 60 % (et jusqu’à 80 %+ dans les flux structurés) des requêtes inadaptées n’atteignent même plus les modèles génératifs coûteux.
- Les modèles frontières et les GPU retrouvent leur véritable rôle : raisonner sur les
15 % à 40 %de requêtes complexes qui justifient réellement leur coût énergétique, financier et temporel. - La sécurité est traitée à la source en
0,17 ms: Le garde-fou 4-rubriques de MicroLLM basé sur le lemme de Neyman-Pearson (Prompt Injection, Commandes destructrices, PII / Secrets, Risque d’hallucination) filtre les abus avant toute exécution aval, sans fuite de données hors du périmètre local.
4. Qualifier la Donnée en Masse en Conditions Réelles : Architecture à 3 Paliers et Preuves Empiriques (128 497 Évaluations sur CPU)
Pour rendre enfin possible le traitement massif de données par l’IA dans des situations réelles — audit temps réel de flux financiers, catégorisation continue de bases documentaires, triage d’incidents sur des millions de logs, qualification de catalogues e-commerce — il faut assembler une hiérarchie décisionnelle à trois paliers inspirée des hiérarchies de caches et d’index de bases de données :
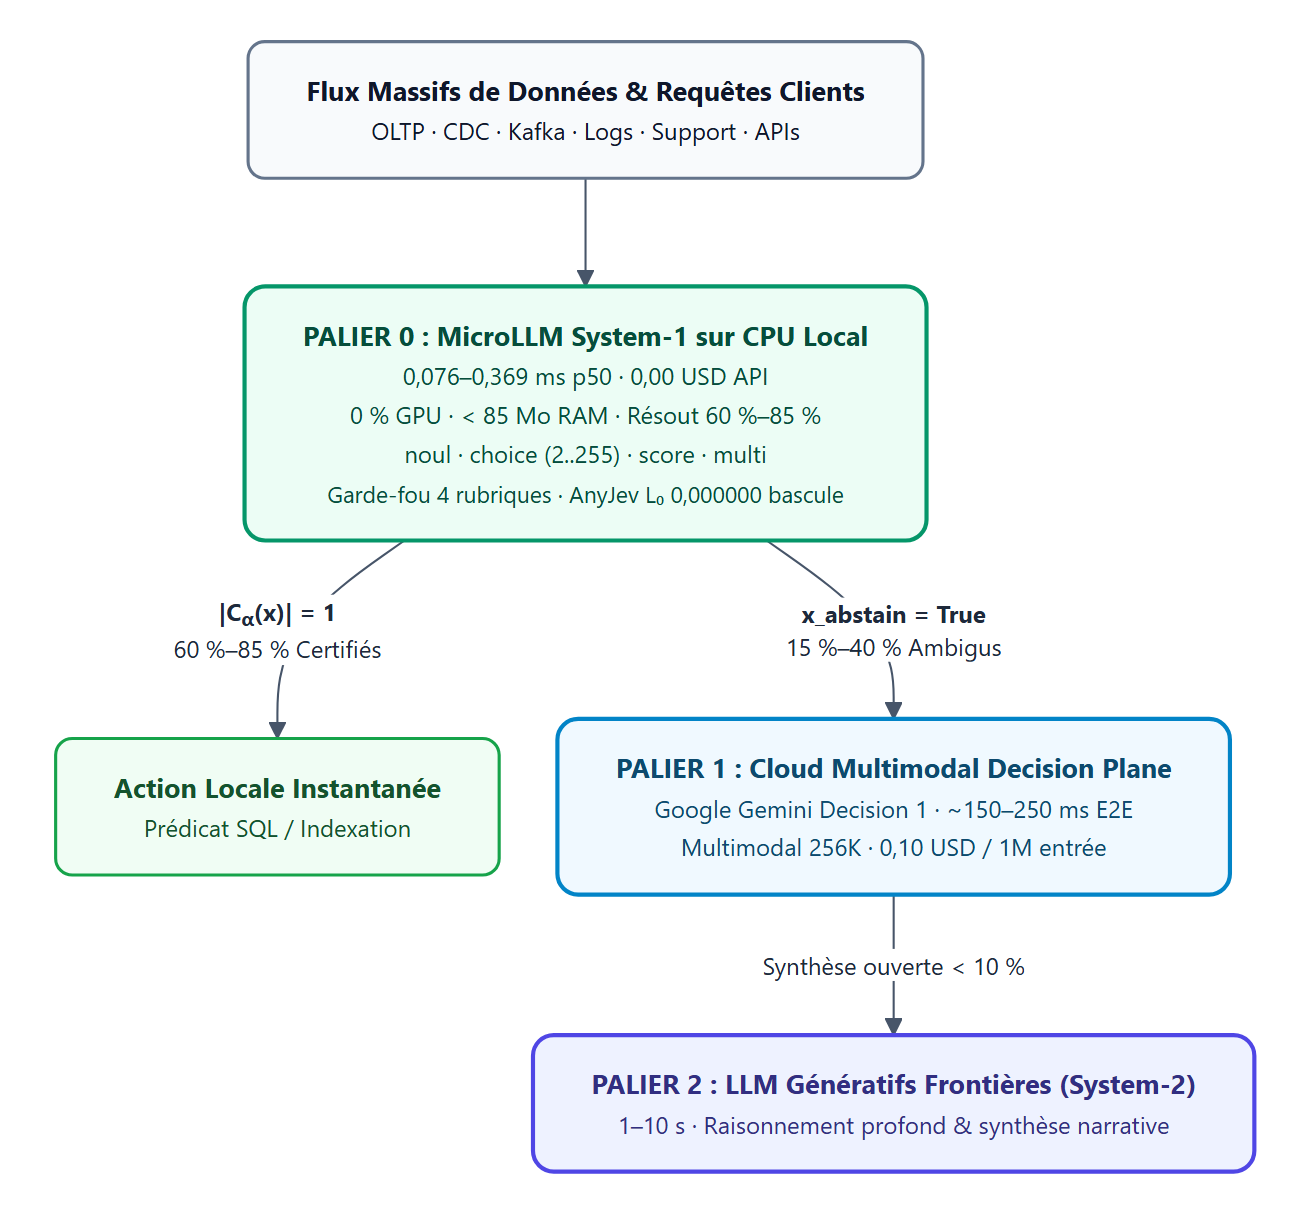
MicroLLM System-1 sur CPU (< 0,4 ms, 0,00 USD d’API) avec abstention conforme vers Gemini Decision 1 et les LLM System-2.Des Résultats Mesurés, Reproductibles en Une Commande sur Un Simple CPU de PC Portable
Contrairement aux annonces théoriques nécessitant des grappes de H100, tous les résultats de MicroLLM v0.3.0 sont vérifiables localement sur un unique thread CPU (AMD Ryzen AI 9 365, 0 % GPU, < 85 Mo RAM, 0,00 USD de coût API) via pip install micro-jev && microllm benchmark --all-suites :
- 11 000 cas structurés d’entreprise (
18domaines métier) :99,75 %de précision brute (10 973 / 11 000) et100,00 %de précision sélective (27 / 27cas limites capturés automatiquement par l’abstention conformex_abstain).- Latence médiane
p50 = 0,076 ms(0,076–0,190 ms), jusqu’à8 601 décisions par secondesur un seul cœur CPU.
- 114 018 lignes complètes et non échantillonnées issues de 16 jeux publics externes (
BoolQ,MultiNLI,Banking77,AG News,CLINC150,Amazon,Yelp 50k,GoEmotions,Reuters,WildGuardMix,ToxicChat,Deepset,ChoiceBench,Callo-Bias,RouteLLM,JevBench) :87,49 %de précision sélective en zero-shot pur sur CPU en53,14 secondesau total (66,82 %brut sur114 018lignes, avec un écart de séparation de confiance de+0,3445entre prédictions justes et erreurs).- Performances par domaine au palier sélectif :
99,97 %surYelp 50k,99,51 %surAG News,99,24 %surAmazon,98,74 %surBanking77,95,34 %surReuterset92,60 %surRouteLLM (10k).
- Invariance stricte à l’ordre des options (
0,000000Flip Rate) :- Aucune bascule sur l’ensemble des
1 867permutations externes (ChoiceBench+Callo-Bias) ni sur les60testsAnyJev-Order(K = 2..20), contre28 % à 50 %d’instabilité observée sur des LLM génératifs non rotatifs.
- Aucune bascule sur l’ensemble des
- Calibration probabiliste & sécurité :
- Erreur de calibration attendue (ECE) abaissée de
15,85 %à6,15 %(3,67 %sur la pisteG5), couverture conforme certifiée à98,75 % / 100,0 %, et100,0 %de F1 /0,0 %de faux positifs sur les 4 rubriques de garde-fous de base (88,49 %sur les5 083conversations réellesToxicChat).
- Erreur de calibration attendue (ECE) abaissée de
Exemple Concret : Qualification et Routage de Masse en Python
Voici comment intégrer ce filtre de proximité (Gear 1 + Gear 2 AnyJev L₀ + abstention conforme) devant un pipeline de données ou un routeur de requêtes clients :
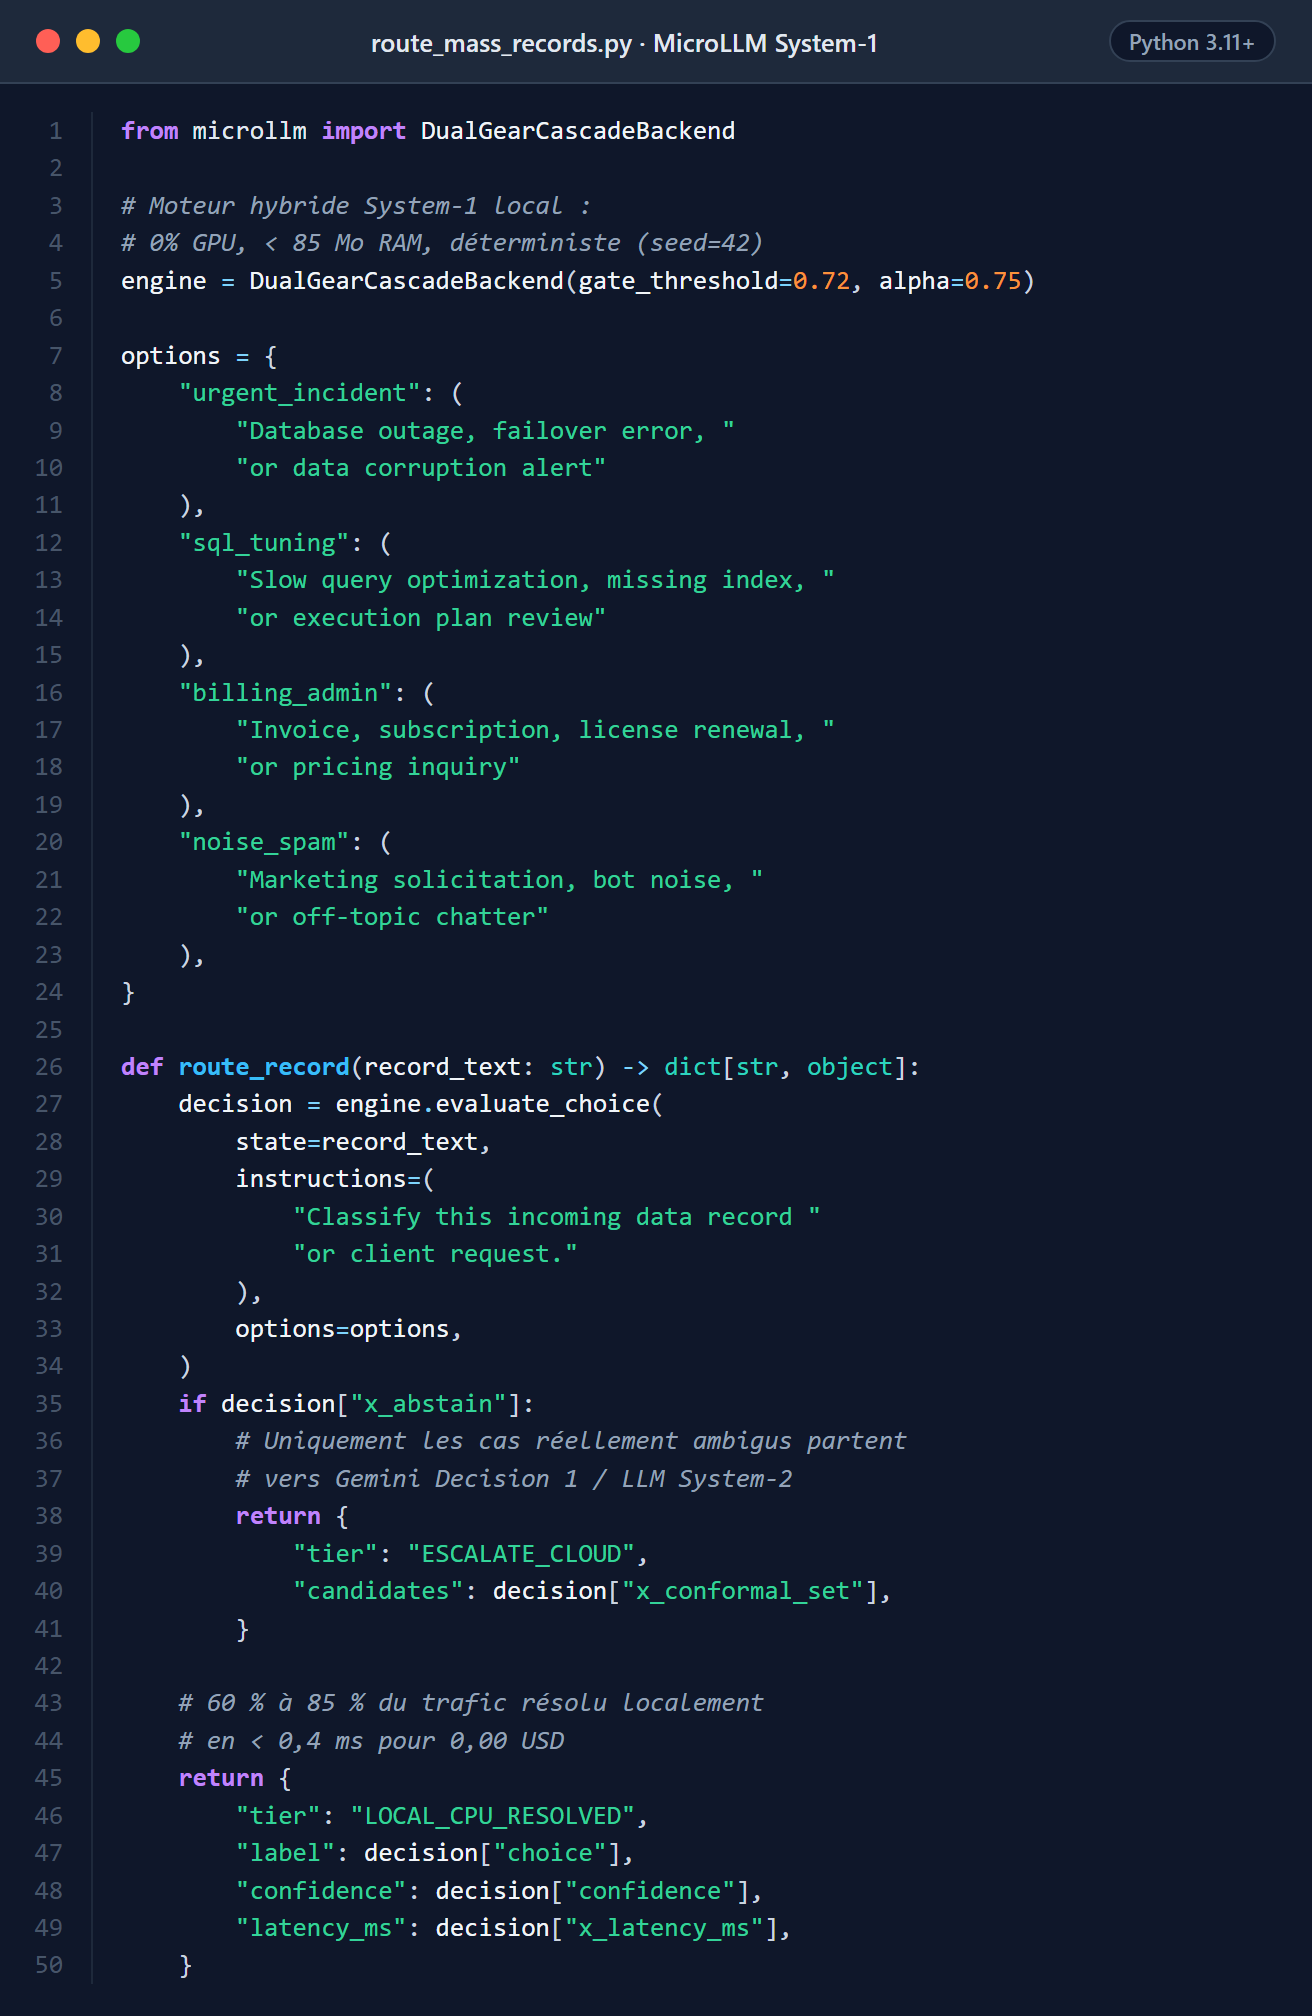
📋 Afficher / copier le code source Python
from microllm import DualGearCascadeBackend

# Moteur hybride System-1 local :
# 0% GPU, < 85 Mo RAM, déterministe (seed=42)
engine = DualGearCascadeBackend(gate_threshold=0.72, alpha=0.75)

options = {
    "urgent_incident": (
        "Database outage, failover error, "
        "or data corruption alert"
    ),
    "sql_tuning": (
        "Slow query optimization, missing index, "
        "or execution plan review"
    ),
    "billing_admin": (
        "Invoice, subscription, license renewal, "
        "or pricing inquiry"
    ),
    "noise_spam": (
        "Marketing solicitation, bot noise, "
        "or off-topic chatter"
    ),
}

def route_record(record_text: str) -> dict[str, object]:
    decision = engine.evaluate_choice(
        state=record_text,
        instructions=(
            "Classify this incoming data record "
            "or client request."
        ),
        options=options,
    )
    if decision["x_abstain"]:
        # Uniquement les cas réellement ambigus partent
        # vers Gemini Decision 1 / LLM System-2
        return {
            "tier": "ESCALATE_CLOUD",
            "candidates": decision["x_conformal_set"],
        }

    # 60 % à 85 % du trafic résolu localement
    # en < 0,4 ms pour 0,00 USD
    return {
        "tier": "LOCAL_CPU_RESOLVED",
        "label": decision["choice"],
        "confidence": decision["confidence"],
        "latency_ms": decision["x_latency_ms"],
    }
5. Une Vision Ouverte : Faire Progresser les Modèles de Décision au Cœur des Données
Soyons parfaitement lucides et humbles sur l’état actuel de MicroLLM : ce projet open source (Apache-2.0) est développé avec des ressources volontairement modestes et restreintes. Il ne prétend pas remplacer les modèles frontières ni concurrencer la puissance multimodale à 256K tokens d’un modèle comme Gemini Decision 1.
Son ambition est complémentaire — et stratégique pour tout l’écosystème IA :
- Apporter la culture du traitement de données à grande échelle dans les architectures d’IA : ne jamais gaspiller du calcul génératif quand une micro-décision calibrée suffit.
- Démontrer dès aujourd’hui qu’un routage System-1 proche du client et proche du disque peut absorber à court terme ~60 % des requêtes inadaptées avant qu’elles n’engorgent les modèles lourds.
- Rendre enfin possible la qualification massive de données en situations réelles, avec une explicabilité par token, un contrôle statistique du risque (
α) et un coût énergétique divisé par plusieurs ordres de grandeur.
Pour que cette vision passe de la preuve de concept vérifiée à un standard industriel intégré au cœur des moteurs de bases de données, des passerelles d’inférence et des grands éditeurs d’IA, nous recherchons activement des échanges, des retours critiques et des collaborations — avec les chercheurs des papiers fondateurs, les équipes Decision Models des grands laboratoires et les architectes de plateformes de données.
Ressources et Liens du Projet
- Code source & Documentation (Apache-2.0) : github.com/jmrenouard/MicroLLM
- Démonstration Interactive en Ligne (
Decision Studio) : huggingface.co/spaces/jmrenouard/microllm-decision-studio - Jeux de Benchmarks & Télémétrie (
128 497+évaluations) : huggingface.co/datasets/jmrenouard/microllm-benchmarks - Annonce Google DeepMind de référence : Gemini Decisions API — Google Blog (Min Choi & Felix Yu)
- Dossier technique détaillé MicroLLM (
jmrenouard.fr) : MicroLLM (micro-jev) : Moteur de Décision System-1 sur CPU, Calibration Conforme RLCD² et Garde-Fous IA Neyman-Pearson - Installation & Reproduction locale en 1 ligne :
pip install micro-jev && microllm benchmark --all-suites